

Grok vs. ChatGPT lässt sich nicht sinnvoll nur über allgemeine Eindrücke vergleichen. Entscheidend ist, wie beide KI-Assistenten mit konkreten Aufgaben umgehen. Deshalb wurden fünf identische Prompts mit beiden Modellen durchgeführt. Getestet wurden unter anderem Texterstellung, Überarbeitung, Textanalyse, Kundennotizen und eine konkrete Zahlenaufgabe.
Kurzantwort
Grok vs. ChatGPT zeigt in diesen fünf Praxistests kein eindeutiges Ergebnis. Beide Modelle lösen mehrere Aufgaben korrekt und liefern teilweise sehr ähnliche Antworten. Unterschiede zeigen sich vor allem beim Befolgen vieler einzelner Vorgaben und bei der Interpretation von Informationen. Der Vergleich zeigt deshalb weniger einen allgemeinen Sieger als unterschiedliche Ergebnisse je nach Aufgabe.
Grok vs. ChatGPT: Was wurde getestet?
Für den Vergleich wurden fünf Aufgaben ausgewählt, die bei Selbstständigen und kleinen Unternehmen regelmäßig vorkommen können:
- Einen LinkedIn-Beitrag nach mehreren Vorgaben schreiben
- Einen vorhandenen Text überarbeiten
- Informationen aus einem Text analysieren
- Ungeordnete Kundennotizen in eine Arbeitsgrundlage umwandeln
- Eine einfache Geschäftsrechnung mit mehreren Kostenpositionen lösen
Bei jedem Test wurde derselbe Prompt in Grok und ChatGPT verwendet.
Das ist kein wissenschaftlicher Benchmark. Es geht um einen praktischen Vergleich. Entscheidend ist deshalb nicht nur, ob die Antwort gut klingt. Geprüft wird auch, ob das Modell die konkrete Aufgabe vollständig ausführt.
Test 1: Kann die KI einen LinkedIn-Beitrag mit vielen Vorgaben erstellen?
Der erste Test prüft eine typische Aufgabe aus dem Content-Alltag.
Der Prompt verlangt einen LinkedIn-Beitrag zum Thema Zeitersparnis durch KI. Gleichzeitig gibt es mehrere Einschränkungen. Der Text soll maximal 180 Wörter lang sein, eine konkrete Alltagssituation enthalten und genau drei Aufgaben nennen und erklären. Außerdem soll mindestens ein konkretes Beispiel enthalten sein.
Der Text soll natürliches, sachliches Deutsch für den DACH-Raum verwenden. Emojis, Hashtags, übertriebene Formulierungen und garantierte Aussagen zur Zeitersparnis sind ausgeschlossen. Am Ende soll genau eine Frage stehen.
Prompt des Tests
Erstelle einen LinkedIn-Beitrag für einen deutschsprachigen KI-Kanal zum Thema Zeit sparen mit KI.

Der Beitrag darf maximal 180 Wörter lang sein.

Vorgaben:

• Beschreibe eine konkrete Alltagssituation.

• Nenne genau 3 konkrete Aufgaben, bei denen KI unterstützen kann.

• Erkläre kurz, wie KI bei diesen Aufgaben helfen kann.

• Verwende mindestens ein konkretes Beispiel.

• Schreibe natürliches, sachliches Deutsch für den DACH-Raum.

• Verwende keine Emojis.

• Verwende keine Hashtags.

• Verwende keine übertriebenen oder werblichen Formulierungen.

• Versprich keine garantierte Zeitersparnis.

• Beende den Beitrag mit genau einer Frage.

Gib ausschließlich den fertigen LinkedIn-Beitrag aus.
Was Grok gemacht hat
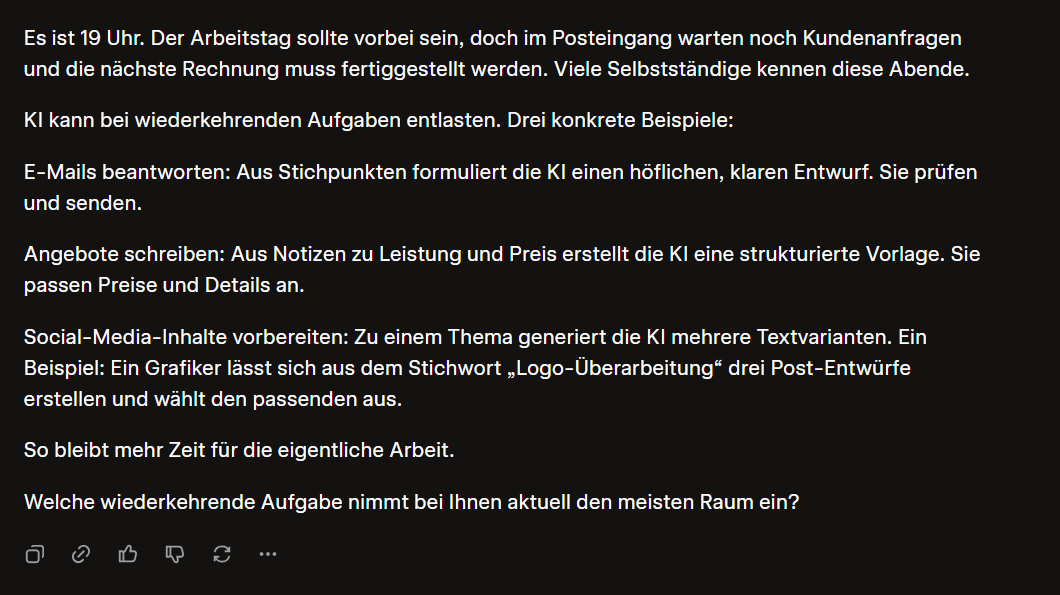
Grok wählte eine konkrete Situation um 19 Uhr. Im Mittelpunkt standen unter anderem der Posteingang und eine Rechnung.
Als Aufgaben wurden E-Mails, Angebote und Social Media Inhalte genannt. Als konkretes Beispiel wurde die Überarbeitung eines Logos verwendet.
Am Ende stellte Grok genau eine Frage.
Was ChatGPT gemacht hat
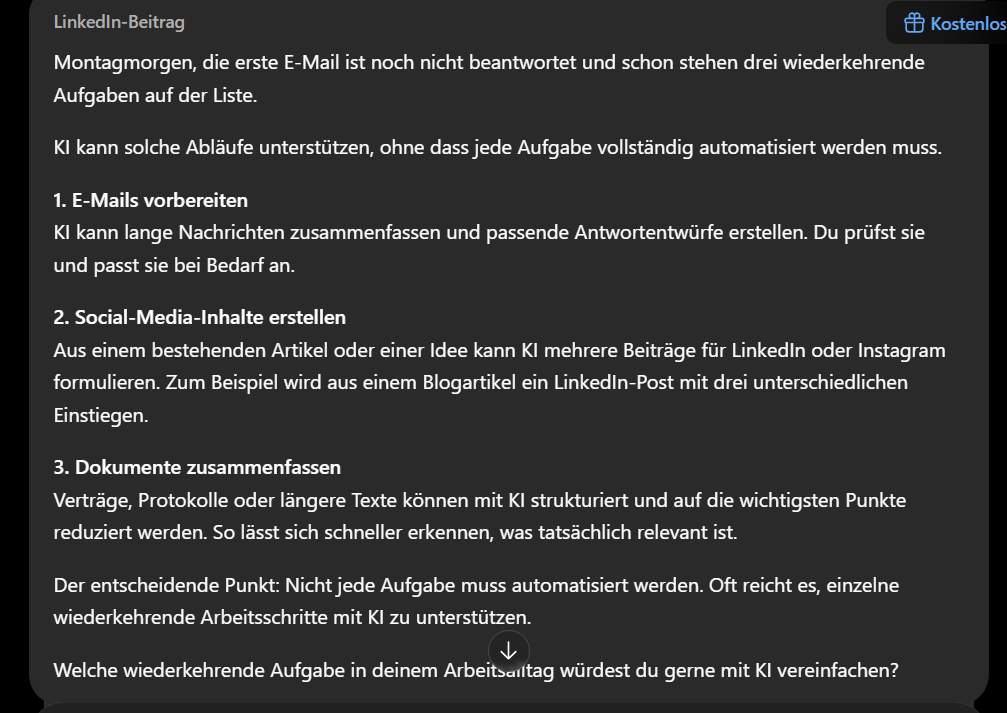
ChatGPT wählte dagegen eine Montagmorgen-Situation.
Als Aufgaben wurden E-Mails, Social Media Inhalte und Dokumente genannt. Als konkretes Beispiel wurde aus einem Blogartikel ein LinkedIn Beitrag gemacht.
Auch ChatGPT beendete den Beitrag mit genau einer Frage.
Was zeigt der Test?
Beide Antworten erfüllen die wichtigsten formalen Anforderungen.
Der auffälligste Unterschied liegt nicht in einem klaren Fehler, sondern in der gewählten Umsetzung. Grok baut den Beitrag stärker um eine konkrete Abendsituation auf. ChatGPT verwendet eine Montagmorgen-Situation und ergänzt eine vorsichtigere Aussage dazu, dass nicht jede Aufgabe automatisiert werden muss.
Das ist ein gutes Beispiel dafür, warum ein einzelner Content-Test nur begrenzt aussagekräftig ist. Beide Antworten können die gleiche Aufgabe unterschiedlich interpretieren, ohne dass eine davon automatisch falsch ist.
Test 2: Kann die KI einen vorhandenen Text zuverlässig überarbeiten?
Der zweite Test ist enger definiert.
Hier darf das Modell keine neuen Fakten hinzufügen. Es soll Wiederholungen entfernen, natürliches Deutsch schreiben und die ursprüngliche Bedeutung erhalten.
Zusätzlich gibt es eine klare Strukturvorgabe: drei kurze Absätze, maximal 150 Wörter und anschließend drei Stichpunkte zu den vorgenommenen Änderungen.
Prompt des Tests
Überarbeite den folgenden Text für einen deutschsprachigen Blog eines KI-Kanals.

Vorgaben:

- Behalte alle sachlichen Informationen aus dem Ausgangstext bei.

- Füge keine neuen Fakten hinzu.

- Entferne Wiederholungen.

- Schreibe natürliches, modernes Deutsch.

- Der Text soll verständlich und sachlich klingen, nicht werblich.

- Behalte die ursprüngliche Aussage und Bedeutung bei.

- Strukturiere den Text in 3 kurze Absätze.

- Maximal 150 Wörter.

- Erkläre anschließend in 3 kurzen Stichpunkten, welche Änderungen du vorgenommen hast.

Ausgangstext:

Viele Selbstständige nutzen mittlerweile KI für verschiedene Aufgaben. KI kann zum Beispiel dabei helfen, Texte zu schreiben, E-Mails vorzubereiten oder Informationen zusammenzufassen. Allerdings bedeutet die Nutzung von KI nicht automatisch, dass jede Aufgabe schneller erledigt wird. Die Qualität des Ergebnisses hängt auch davon ab, welche Informationen man der KI gibt und wie genau die Aufgabe beschrieben wird. Deshalb ist es sinnvoll, Ergebnisse zu kontrollieren und bei wichtigen Aufgaben nicht einfach alles ungeprüft zu übernehmen. Besonders bei wiederkehrenden Aufgaben kann es hilfreich sein, einen guten Ablauf zu entwickeln und diesen anschließend regelmäßig zu verwenden.
Ergebnis von Grok
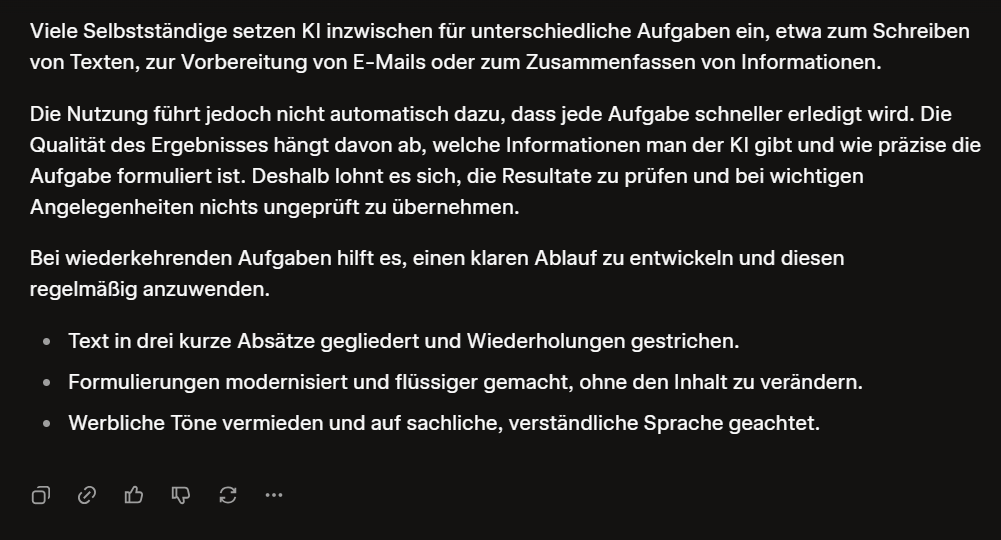
Grok liefert drei kurze Absätze und bleibt unter der Wortgrenze.
Auch die anschließenden drei Stichpunkte sind vorhanden. Darin erklärt das Modell, dass es den Text strukturiert, Formulierungen modernisiert und einen sachlichen Ton beibehalten hat.
Ergebnis von ChatGPT
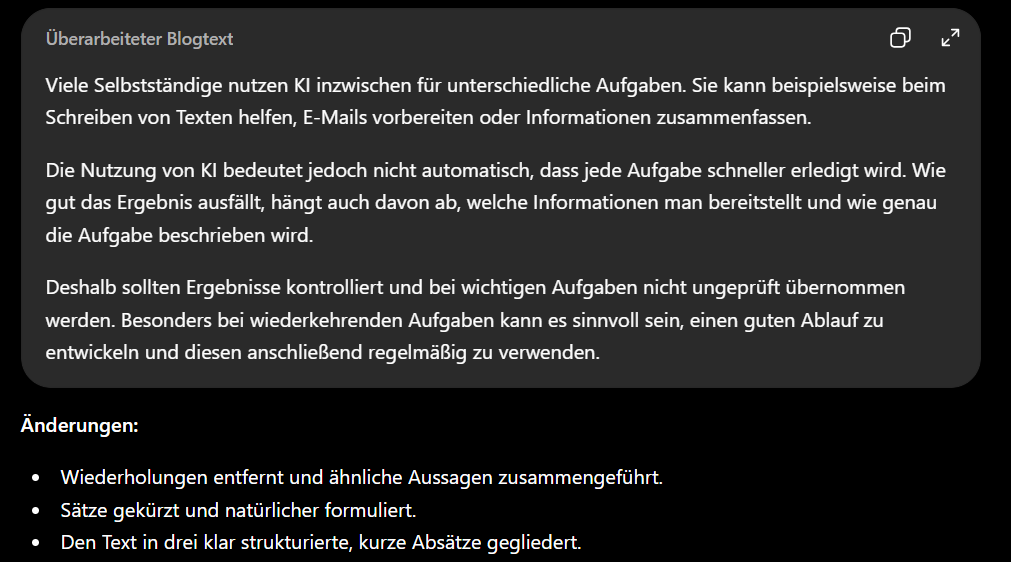
ChatGPT überarbeitet den Text ebenfalls in drei Absätzen und bleibt unter 150 Wörtern.
Die eigentliche Überarbeitung ist sachlich und nah am Ausgangstext. Eine Vorgabe fehlt allerdings: Die verlangten drei Stichpunkte mit einer Erklärung der vorgenommenen Änderungen erscheinen nicht.
Was zeigt der Test?
Hier gibt es einen klareren Unterschied als im ersten Test.
ChatGPT produziert einen guten überarbeiteten Text, führt aber nicht die komplette Aufgabe aus. Grok erfüllt dagegen auch den letzten Teil des Prompts.
Das ist bei KI im Arbeitsalltag relevant. Eine Antwort kann sprachlich gut sein und trotzdem die Aufgabe nur teilweise erledigen.
Beobachtung aus Test 2: Grok erfüllt in diesem Test mehr der ausdrücklich genannten Vorgaben. ChatGPT lässt einen Teil der Aufgabe weg.
Test 3: Kann die KI Informationen aus einem Text korrekt analysieren?
Im dritten Test geht es nicht mehr um das Schreiben eines neuen Textes.
Beide Modelle bekommen denselben kurzen Text über Solo Selbstständige, die KI für Content nutzen. Anschließend sollen sie vier wichtige Aussagen, drei Probleme, drei Handlungsempfehlungen und eine Zusammenfassung mit maximal 50 Wörtern erstellen.
Besonders wichtig ist die Vorgabe, ausschließlich Informationen aus dem Ausgangstext zu verwenden.
Prompt des Tests
Analysiere den folgenden Text und beantworte die Aufgabe ausschließlich auf Grundlage der darin enthaltenen Informationen.

Erstelle:

1. Eine Liste mit den 4 wichtigsten Aussagen des Textes.

2. Die 3 konkreten Probleme, die im Text genannt werden.

3. 3 Handlungsempfehlungen, die sich direkt aus dem Text ableiten lassen.

4. Eine kurze Zusammenfassung mit maximal 50 Wörtern.

Wichtig:

- Erfinde keine Informationen.

- Füge keine Beispiele hinzu, die nicht im Text vorkommen.

- Unterscheide klar zwischen Aussagen des Textes und deinen eigenen Schlussfolgerungen.

- Schreibe präzise und verständlich.

Text:

Viele Solo-Selbstständige nutzen KI inzwischen für die Erstellung von Inhalten. Trotzdem verbringen sie weiterhin viel Zeit mit der Vorbereitung. Häufig liegt das daran, dass Ideen, Notizen und bereits veröffentlichte Inhalte an verschiedenen Orten gespeichert sind.

Ein weiteres Problem ist, dass viele Selbstständige für jeden neuen Beitrag wieder von vorne beginnen. Sie formulieren jedes Mal einen neuen Prompt und erklären der KI erneut ihre Zielgruppe, ihren Stil und ihre Ziele.

Auch die Kontrolle der Ergebnisse kostet Zeit. KI kann Texte schnell erstellen, aber die Inhalte müssen weiterhin auf Fehler, Tonalität und passende Informationen geprüft werden.

Ein strukturierter Arbeitsablauf kann diese Probleme reduzieren. Wer beispielsweise Informationen, Zielgruppe, Stilvorgaben und erfolgreiche frühere Inhalte an einem festen Ort sammelt, muss diese Grundlagen nicht bei jeder neuen Aufgabe erneut zusammenstellen.
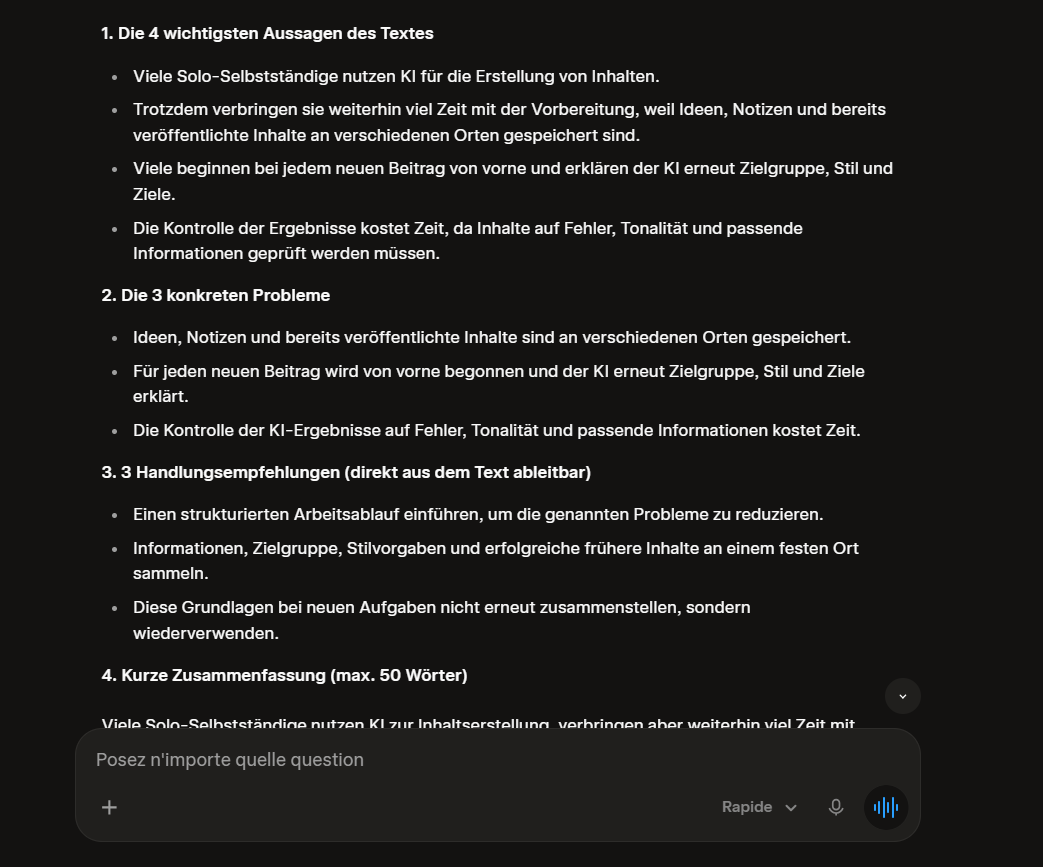
Ergebnis von ChatGPT
ChatGPT identifiziert die vier zentralen Aussagen korrekt.
Als Probleme nennt es die verstreuten Informationen, die wiederholte Vorbereitung und die zeitaufwendige Kontrolle der KI Ergebnisse.
Die drei Handlungsempfehlungen bleiben ebenfalls eng am Ausgangstext. Die Zusammenfassung liegt innerhalb der vorgegebenen Grenze.
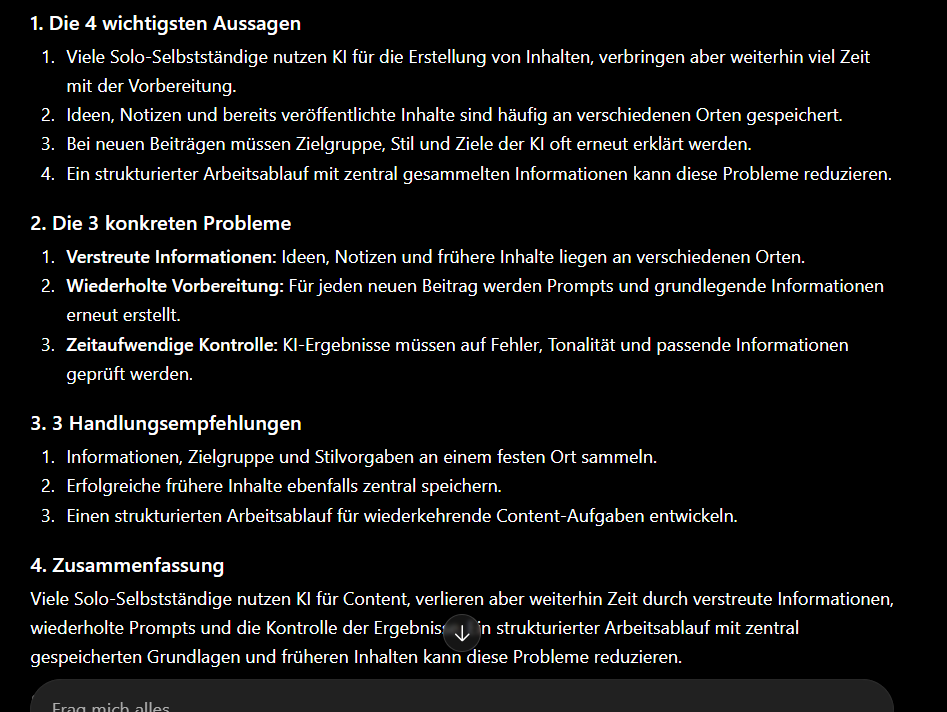
Ergebnis von Grok
Auch Grok identifiziert die zentralen Aussagen und die drei Probleme korrekt.
Die Handlungsempfehlungen leiten sich direkt aus dem letzten Absatz des Ausgangstextes ab. Auch die Zusammenfassung bleibt unter 50 Wörtern.
Was zeigt der Test?
Hier sind die Antworten sehr nah beieinander.
Ein kleiner Unterschied liegt in der Gewichtung. ChatGPT hebt den strukturierten Arbeitsablauf bereits bei den vier wichtigsten Aussagen hervor. Grok bleibt bei dieser Liste stärker bei den einzelnen Problemen und nennt die Kontrolle der Ergebnisse als eigene wichtige Aussage.
Beide Vorgehensweisen lassen sich aus dem Ausgangstext ableiten.
Beobachtung aus Test 3: In diesem Test gibt es keinen deutlichen Unterschied. Beide Modelle halten sich eng an die vorgegebenen Informationen.
Test 4: Kann die KI ungeordnete Kundennotizen strukturieren?
Dieser Test kommt näher an eine typische Arbeitssituation.
Statt eines fertigen Textes bekommt die KI ungeordnete Notizen aus einem Kundengespräch. Daraus soll sie eine verwendbare Arbeitsgrundlage erstellen.
Das Modell muss also Informationen sortieren, Probleme erkennen, nächste Schritte formulieren und Fragen für das nächste Gespräch entwickeln.
Prompt des Tests
Ich hatte gerade ein Gespräch mit einem potenziellen Kunden. Hier sind meine ungeordneten Notizen:

„kleines Beratungsunternehmen, 4 Mitarbeiter, bekommt die meisten Kunden über Empfehlungen, möchte mehr Anfragen über die Website, Website ist vorhanden aber Texte teilweise alt, Geschäftsführer hat wenig Zeit für Social Media, LinkedIn wird unregelmäßig genutzt, bisher keine klare Content-Strategie, möchte nicht jeden Tag posten, Budget noch nicht festgelegt, zuerst Website und LinkedIn verbessern, nächstes Gespräch nächste Woche“

Bereite daraus eine übersichtliche Arbeitsgrundlage für mich vor.

Erstelle:

1. Eine kurze Zusammenfassung des Kundengesprächs in maximal 60 Wörtern.

2. Die 5 wichtigsten Informationen über den Kunden.

3. Die 3 aktuell erkennbaren Probleme.

4. Die 4 nächsten sinnvollen Schritte.

5. 5 Fragen, die ich beim nächsten Gespräch stellen sollte.

Wichtig:

- Verwende ausschließlich Informationen aus den Notizen.

- Erfinde keine Ziele, Probleme oder Bedürfnisse, die nicht genannt oder eindeutig daraus ableitbar sind.

- Kennzeichne Punkte, die eine Annahme darstellen, ausdrücklich als „Annahme“.

- Schreibe sachlich und verständlich.

- Keine Marketingformulierungen.
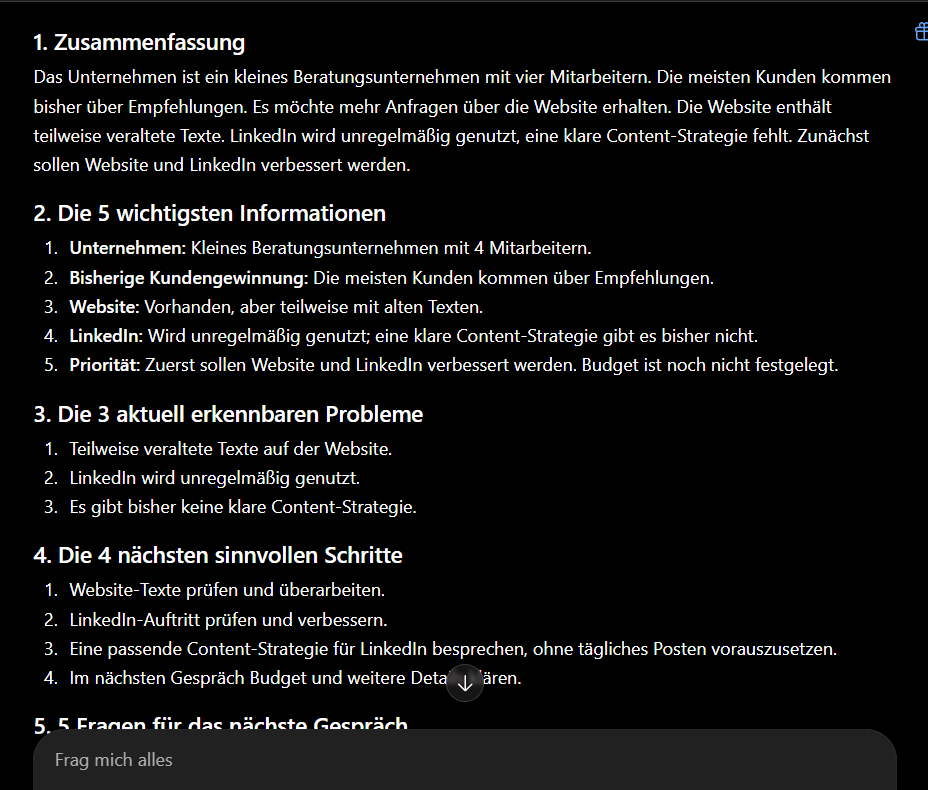
Ergebnis von ChatGPT
ChatGPT strukturiert die Notizen klar.
Es identifiziert als zentrale Informationen unter anderem die Unternehmensgröße, die bisherige Kundengewinnung, die Website, LinkedIn und die geplante Priorität.
Bei den Problemen bleibt ChatGPT nah an den konkreten Notizen. Genannt werden die teilweise veralteten Website Texte, die unregelmäßige LinkedIn Nutzung und die fehlende Content Strategie.
Bei den nächsten Schritten schlägt ChatGPT unter anderem vor, die Website Texte zu prüfen, LinkedIn zu verbessern, eine passende Content Strategie zu besprechen und das Budget im nächsten Gespräch zu klären.
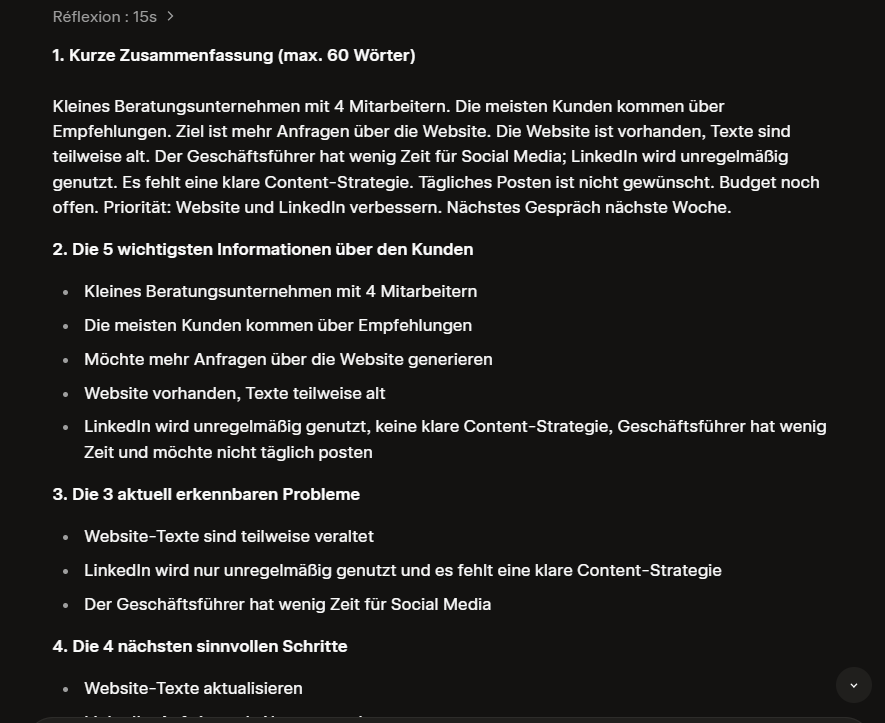
Ergebnis von Grok
Grok kommt zu einer sehr ähnlichen Struktur.
Eine kleine Abweichung gibt es bei der Auswahl der drei Probleme. Grok nennt zusätzlich die geringe Zeit des Geschäftsführers für Social Media als Problem.
Diese Information steht tatsächlich in den Notizen. Grok interpretiert sie allerdings stärker als konkretes Problem.
Auch bei den Fragen für das nächste Gespräch geht Grok etwas stärker ins Detail. Es fragt beispielsweise nach den zeitlichen Ressourcen für LinkedIn und danach, was genau mit mehr Anfragen über die Website erreicht werden soll.
Was zeigt der Test?
Beide Antworten sind brauchbar.
Der Unterschied liegt vor allem in der Interpretation. ChatGPT bleibt etwas näher an den explizit genannten Problemen. Grok nutzt die Informationen etwas stärker, um daraus zusätzliche Arbeitsfragen abzuleiten.
Das ist keine eindeutige Qualitätsfrage. Es hängt davon ab, ob man bei einer solchen Aufgabe eine möglichst textnahe Struktur oder etwas mehr Interpretation erwartet.
Ein formaler Fehler fällt allerdings bei beiden Modellen auf: Die Zusammenfassung überschreitet die Vorgabe von maximal 60 Wörtern.
Beobachtung aus Test 4: Beide Modelle können ungeordnete Informationen sinnvoll strukturieren. Grok interpretiert einzelne Angaben etwas stärker, während ChatGPT näher an der ursprünglichen Formulierung bleibt.
Test 5: Wie zuverlässig sind konkrete Zahlen?
Der fünfte Test ist bewusst anders aufgebaut.
Hier geht es nicht um Sprache, sondern um eine einfache finanzielle Rechnung. Das Modell bekommt fünf konkrete Daten und muss daraus Umsatz, Kosten, Gewinn, Gewinn pro Kunde und den notwendigen Umsatz pro Kunde zur Kostendeckung berechnen.
Dabei müssen mehrere Kostenarten berücksichtigt werden.
Prompt des Tests
Ein Selbstständiger möchte prüfen, ob sich eine bestimmte Werbekampagne finanziell lohnt.

Er hat folgende Zahlen:

- Werbebudget: 600 €

- 30 gewonnene Kunden

- Durchschnittlicher Umsatz pro Kunde: 80 €

- Variable Kosten pro Kunde: 20 €

- Zusätzlich entstehen einmalige Kosten von 300 € für die Erstellung der Kampagne.

Berechne:

1. Den Gesamtumsatz.

2. Die gesamten variablen Kosten.

3. Den Gewinn nach Abzug von Werbebudget, variablen Kosten und einmaligen Kampagnenkosten.

4. Den Gewinn pro gewonnenem Kunden.

5. Wie viel Umsatz pro Kunde mindestens erzielt werden müsste, damit die Gesamtkosten genau gedeckt sind.

Erkläre jeden Rechenschritt kurz und verständlich.

Wichtig:

- Verwende ausschließlich die angegebenen Zahlen.

- Runde nur, wenn es notwendig ist.

- Zeige die verwendeten Formeln.

- Gib am Ende eine kurze Zusammenfassung der Ergebnisse in maximal 3 Sätzen.
Ergebnis von Grok
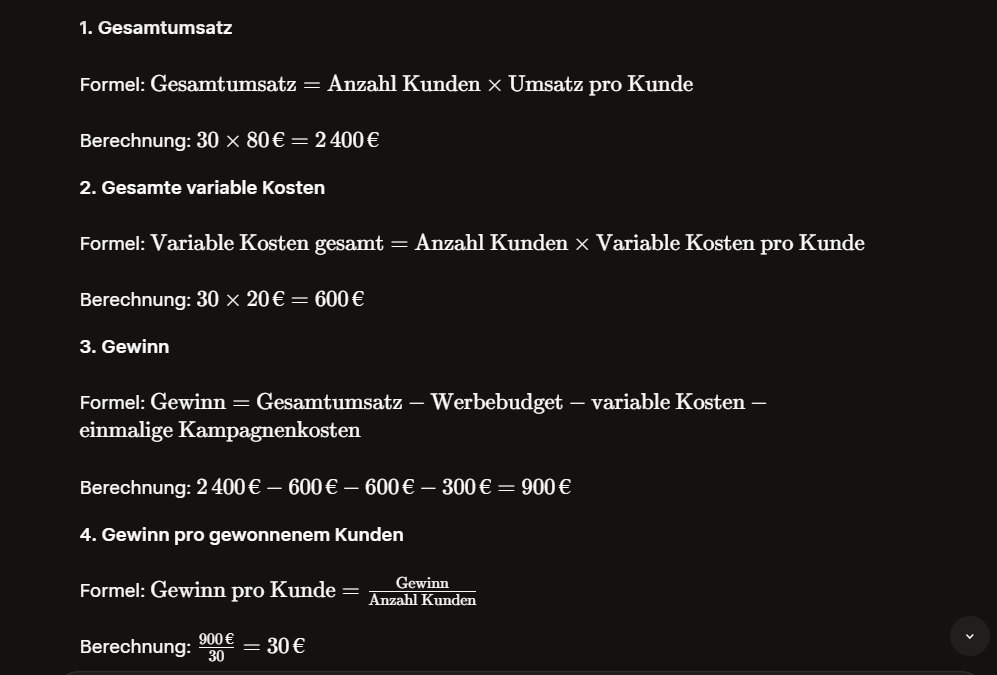
Grok berechnet:
Gesamtumsatz: 2.400 €
Variable Kosten: 600 €
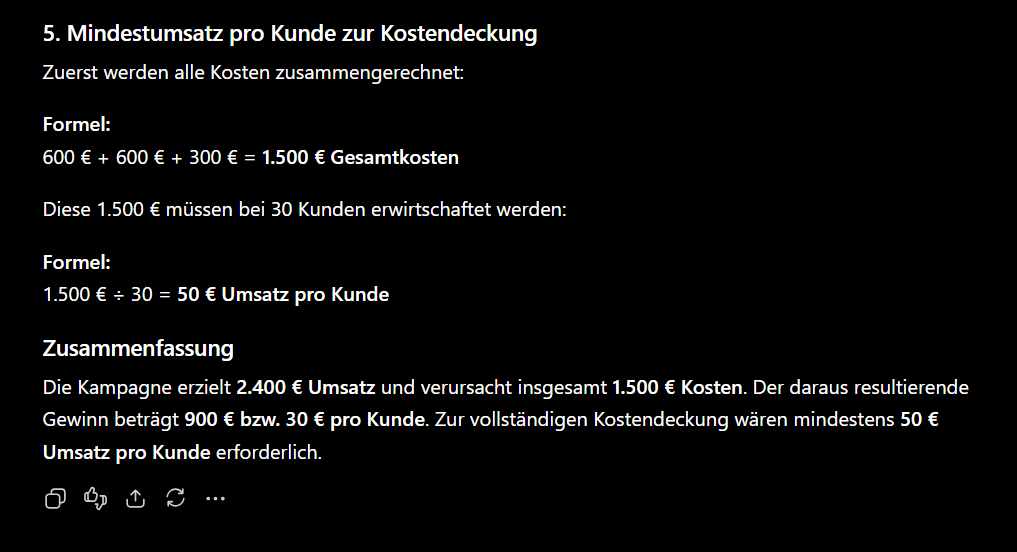
Gesamtkosten: 1.500 €
Gewinn: 900 €
Gewinn pro Kunde: 30 €
Mindestumsatz pro Kunde zur Kostendeckung: 50 €
Die Formeln werden jeweils gezeigt. Auch die Zusammenfassung am Ende besteht aus drei Sätzen.
Ergebnis von ChatGPT
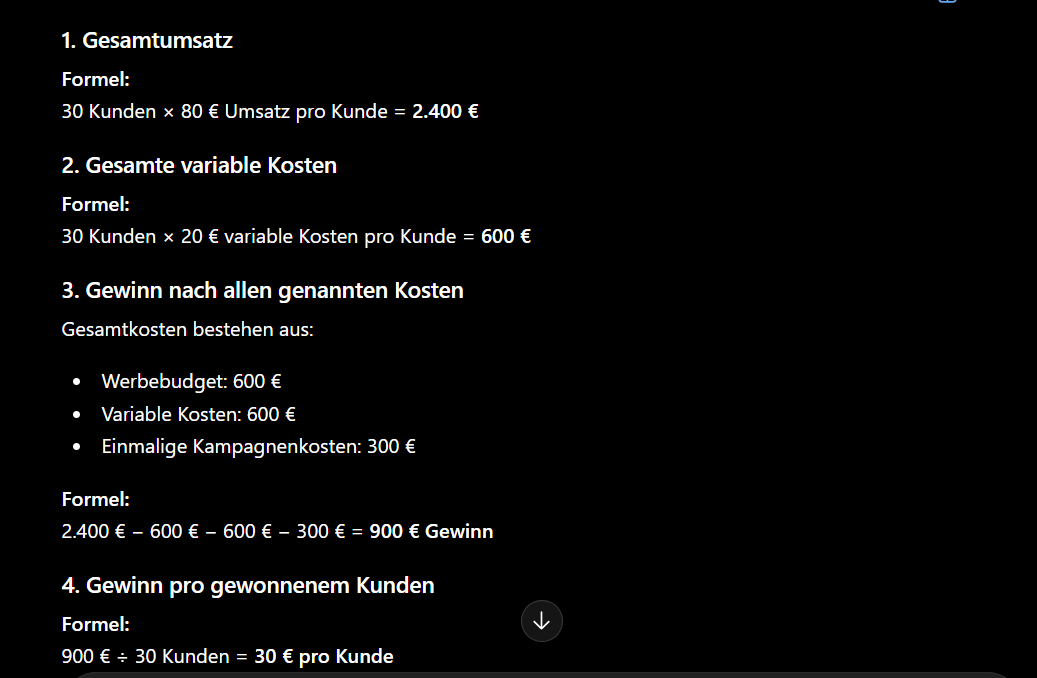
ChatGPT kommt exakt auf dieselben Ergebnisse:
Gesamtumsatz: 2.400 €
Variable Kosten: 600 €
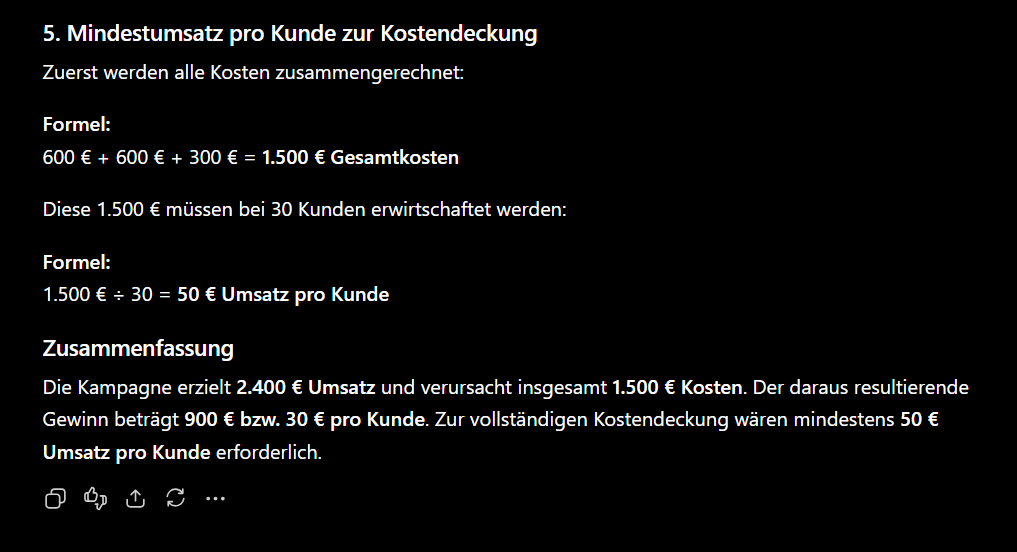
Gesamtkosten: 1.500 €
Gewinn: 900 €
Gewinn pro Kunde: 30 €
Mindestumsatz pro Kunde zur Kostendeckung: 50 €
Auch ChatGPT zeigt die Berechnungen und berücksichtigt alle drei Kostenpositionen. Die abschließende Zusammenfassung bleibt bei drei Sätzen.
Was zeigt der Test?
Hier gibt es keinen relevanten Unterschied.
Beide Modelle berechnen dieselben Werte und berücksichtigen die gleichen Kosten.
Gerade deshalb ist dieser Test nützlich. Ein Vergleich muss nicht in jedem Durchgang einen Unterschied produzieren. Wenn zwei Modelle bei einer klar definierten Rechenaufgabe zum selben Ergebnis kommen, ist das ebenfalls ein Ergebnis.
Was zeigen alle 5 Tests zusammen?
Nach fünf Aufgaben ergibt sich ein differenziertes Bild.
1. Bei klaren Rechenaufgaben liegen beide Modelle gleichauf
Im fünften Test kommen Grok und ChatGPT exakt auf dieselben Ergebnisse.
Die Aufgabe enthält klare Zahlen und eindeutige Formeln. Beide Modelle berücksichtigen alle Kostenpositionen und erklären den Rechenweg.
2. Bei vielen Vorgaben kann eine einzelne Anweisung verloren gehen
Im zweiten Test liefert ChatGPT eine korrekte Textüberarbeitung, vergisst aber die verlangten drei Stichpunkte zu den Änderungen.
Grok erfüllt diese zusätzliche Vorgabe.
Das zeigt einen wichtigen Punkt für den Alltag: Bei KI Antworten sollte nicht nur der Inhalt gelesen werden. Auch die ursprüngliche Aufgabenstellung sollte kurz kontrolliert werden.
3. Bei der Textanalyse sind die Ergebnisse sehr ähnlich
Im dritten Test erfüllen beide Modelle die Aufgaben vollständig.
Beide bleiben bei den Informationen des Ausgangstextes und kommen bei den Problemen und Handlungsempfehlungen zu sehr ähnlichen Ergebnissen.
4. Bei ungeordneten Informationen unterscheiden sich die Interpretationen
Im vierten Test arbeiten beide Modelle die Kundennotizen sinnvoll auf.
Grok interpretiert die geringe verfügbare Zeit des Geschäftsführers stärker als Problem. ChatGPT konzentriert sich stärker auf die ausdrücklich genannten Probleme.
Beide Antworten bleiben grundsätzlich innerhalb der Informationen aus den Notizen.
5. Ein einzelner Test reicht nicht für eine allgemeine Aussage
Die fünf Aufgaben zeigen unterschiedliche Ergebnisse.
Bei der Überarbeitung gibt es einen sichtbaren Unterschied beim Befolgen der Vorgaben. Bei der Textanalyse und der Zahlenaufgabe sind die Antworten sehr ähnlich. Bei den Kundennotizen unterscheiden sich vor allem die Interpretationen.
Damit lässt sich aus diesem kleinen Praxistest keine allgemeine Aussage ableiten, dass ein Modell bei jeder Aufgabe besser arbeitet.
Grok vs. ChatGPT: Was bedeutet das für den Arbeitsalltag?
Für Selbstständige ist eine andere Frage oft wichtiger als die Suche nach einem allgemeinen Gewinner:
Welches Modell passt zur konkreten Aufgabe?
Wenn du Inhalte überarbeiten lässt, solltest du kontrollieren, ob wirklich alle Vorgaben umgesetzt wurden.
Wenn du Informationen aus einem vorhandenen Text analysieren lässt, lohnt sich die Kontrolle darauf, ob das Modell zusätzliche Informationen eingefügt hat.
Bei Kundennotizen solltest du prüfen, welche Punkte reine Informationen und welche Punkte Interpretationen sind.
Bei Zahlen solltest du das Ergebnis trotzdem kurz selbst kontrollieren. Besonders bei geschäftlichen Entscheidungen sollte eine KI Rechnung nicht die einzige Kontrollinstanz sein.
Der wichtigste Punkt aus diesen fünf Tests ist deshalb nicht, welches Logo auf dem Bildschirm steht.
Entscheidend ist der Prompt.
Je genauer die Aufgabe definiert ist, desto leichter lässt sich die Antwort anschließend kontrollieren.
Wenn du häufiger mit ChatGPT arbeitest, findest du weitere direkt nutzbare Beispiele in meinem Artikel 30 ChatGPT Prompts auf Deutsch.
So kannst du die Ergebnisse selbst vergleichen
Du musst für einen Vergleich zwischen zwei KI Modellen keinen komplizierten Benchmark bauen.
Nimm eine Aufgabe, die du tatsächlich regelmäßig erledigst.
Dann:
- Formuliere einen identischen Prompt.
- Verwende exakt dieselben Ausgangsinformationen.
- Nutze dieselben Vorgaben für beide Modelle.
- Vergleiche nicht nur den Schreibstil.
- Kontrolliere Fakten, Zahlen und Format.
- Notiere konkrete Fehler und ausgelassene Vorgaben.
- Wiederhole den Test mit mehreren Aufgabentypen.
Das ist für den eigenen Arbeitsablauf aussagekräftiger als ein einzelner Eindruck nach fünf Minuten.
Passend dazu: Weitere Vergleiche mit ChatGPT: Claude vs ChatGPT und DeepSeek vs ChatGPT.
FAQ
Ist Grok besser als ChatGPT?
Die fünf Tests zeigen keinen allgemeinen Sieger. Beide Modelle lösen mehrere Aufgaben korrekt. Unterschiede gibt es vor allem beim Befolgen einzelner Vorgaben und bei der Interpretation von Informationen.
Welches Modell eignet sich für Content?
Beide können Texte erstellen und überarbeiten. Der Vergleich zeigt, dass du bei beiden prüfen solltest, ob alle Vorgaben deines Prompts umgesetzt wurden.
Sind die Ergebnisse aus fünf Tests repräsentativ?
Nein. Die Tests zeigen konkrete Ergebnisse bei fünf ausgewählten Aufgaben. Sie sind kein wissenschaftlicher Benchmark und lassen keine allgemeine Aussage über alle möglichen Aufgaben zu.
Kann ich KI für geschäftliche Berechnungen verwenden?
Für einfache Berechnungen können KI Modelle den Rechenweg nachvollziehbar darstellen. Geschäftliche Entscheidungen sollten trotzdem anhand der zugrunde liegenden Zahlen kontrolliert werden.
Was ist beim Vergleich von KI Modellen am wichtigsten?
Verwende dieselbe Aufgabe, dieselben Informationen und denselben Prompt. Vergleiche anschließend konkrete Kriterien wie Genauigkeit, Vollständigkeit, Format und Umgang mit Vorgaben.
Fazit
Grok vs. ChatGPT ergibt in diesem Praxistest kein eindeutiges Duell mit einem Modell als allgemeinem Sieger.
Grok folgt im zweiten Test mehr Vorgaben vollständig. Bei der Textanalyse liefern beide sehr ähnliche Ergebnisse. Bei den Kundennotizen interpretiert Grok einzelne Angaben etwas stärker. Bei der Zahlenaufgabe sind die Ergebnisse identisch.
Für den Arbeitsalltag ist deshalb ein eigener Praxistest sinnvoller als eine pauschale Aussage.
Nimm die Aufgaben, die du tatsächlich jeden Tag erledigst. Gib beiden Modellen denselben Prompt. Vergleiche anschließend nicht nur, welcher Text besser klingt, sondern ob die Aufgabe vollständig, korrekt und nachvollziehbar ausgeführt wurde.
Genau dort zeigt sich, welches Modell zu deinem konkreten Workflow passt.


